 deDeutsch

Ein Prompt, vier Bildmodelle: tuomiAI Creative im Praxistest
19.11.2026 · KI-Bildgenerierung
Vier Bildmodelle, ein identischer Prompt: Wir haben denselben Buchladen von Google, OpenAI, xAI und Hugging Face generieren lassen – und zeigen, worin sich die Ergebnisse unterscheiden.
tuomiAI Creative ist das Bild- und Video-Studio der tuomiAI-Plattform. Statt für jedes Modell ein eigenes Abo und eine eigene Oberfläche zu brauchen, stehen dort mehrere Anbieter in einem Werkzeug bereit – vom Prompt über die Referenzbilder bis zur Nachbearbeitung. Wir haben uns den Demo-Account angesehen und vier Bildmodelle mit exakt demselben Prompt gegeneinander laufen lassen.
Ein Studio, viele Anbieter
Die Oberfläche ist bewusst schlicht: links der Prompt, das Format und die Modellwahl, rechts das Ergebnis. Dazwischen liegen die Stellschrauben, die den Unterschied machen – bis zu vier Referenzbilder, zehn Kategorien an Kunststilen und eine Bildbearbeitung, die ohne Neugenerierung auskommt. Alles läuft im Browser; die Verarbeitung übernimmt die Plattform, gehostet in der EU.
Welche Modelle ein Konto sieht, legt der Mandant fest: Der Administrator gibt pro Nutzer oder Tarif frei, welche Bildmodelle in der Auswahlliste erscheinen. Im Demo-Account waren zum Zeitpunkt dieses Artikels acht Modelle freigeschaltet.
Der Vergleich: ein Prompt, vier Modelle
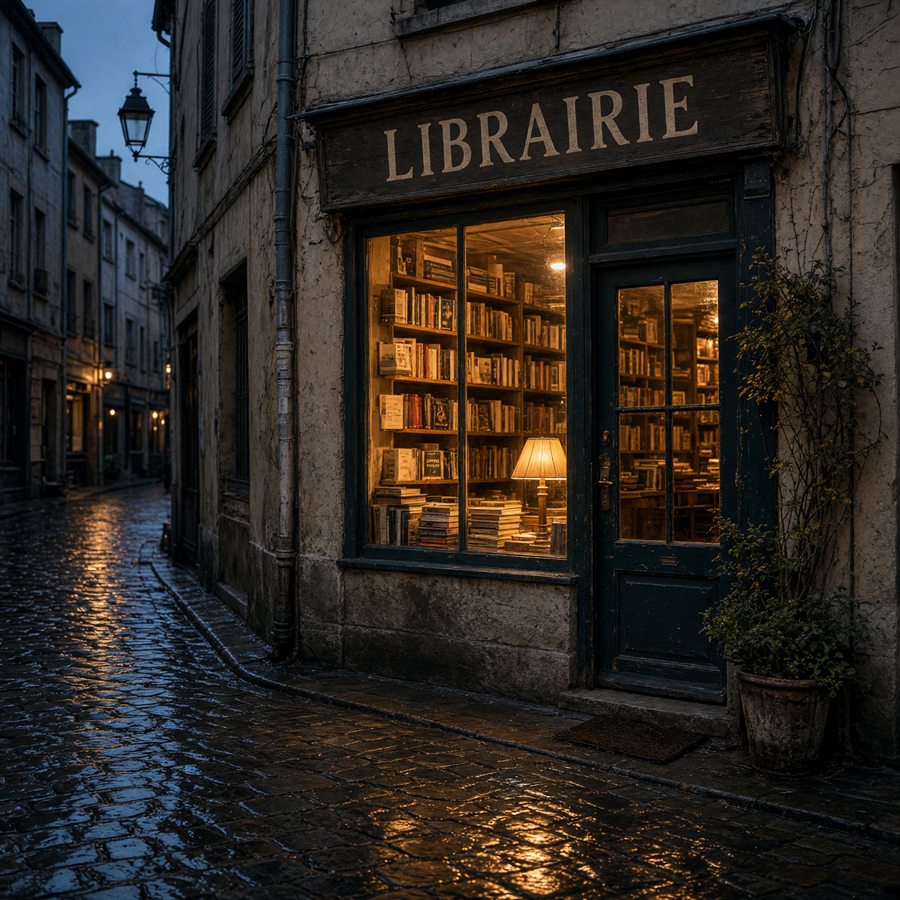
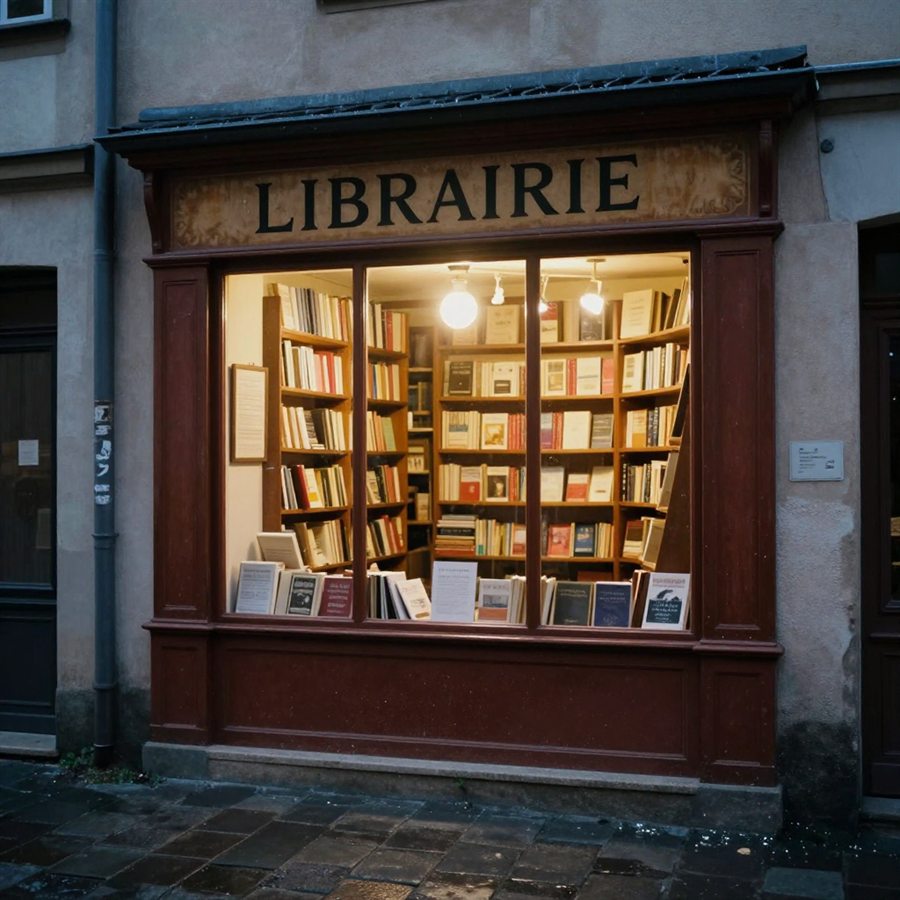
Für einen fairen Vergleich haben wir alles gleich gelassen: denselben Prompt, dasselbe Format (1:1), keine Kunststile, keine Referenzbilder. Getauscht wurde nur das Modell. So wird sichtbar, wie unterschiedlich vier Anbieter dieselbe Beschreibung lesen.
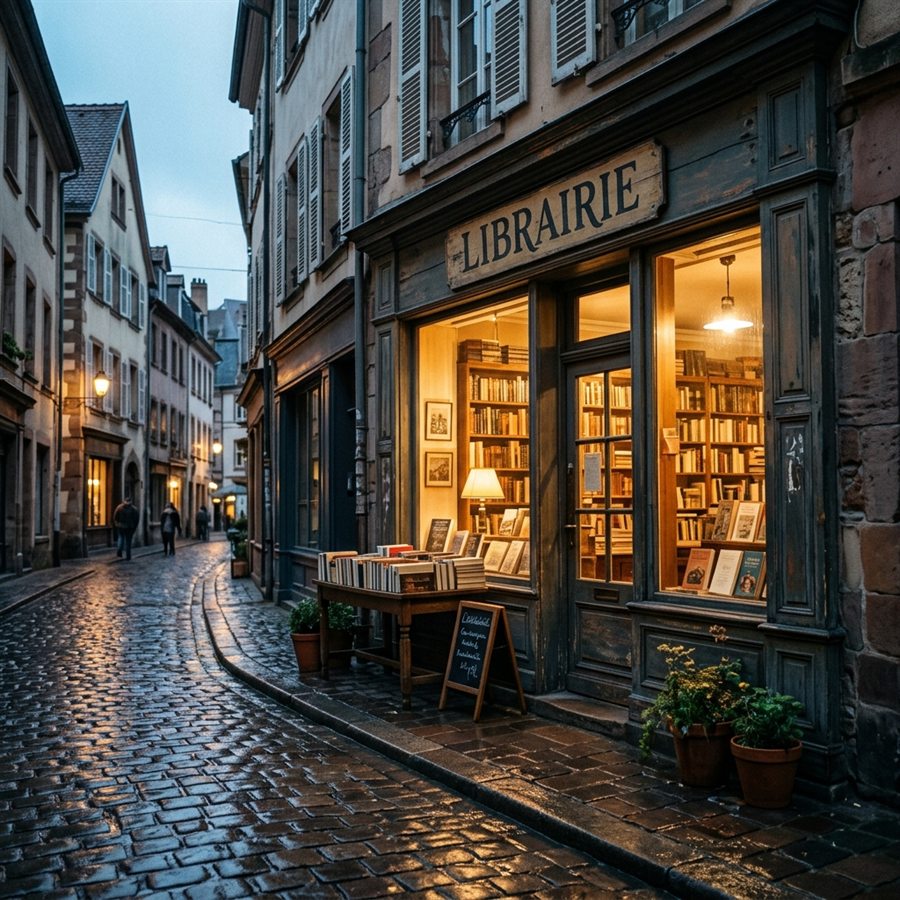
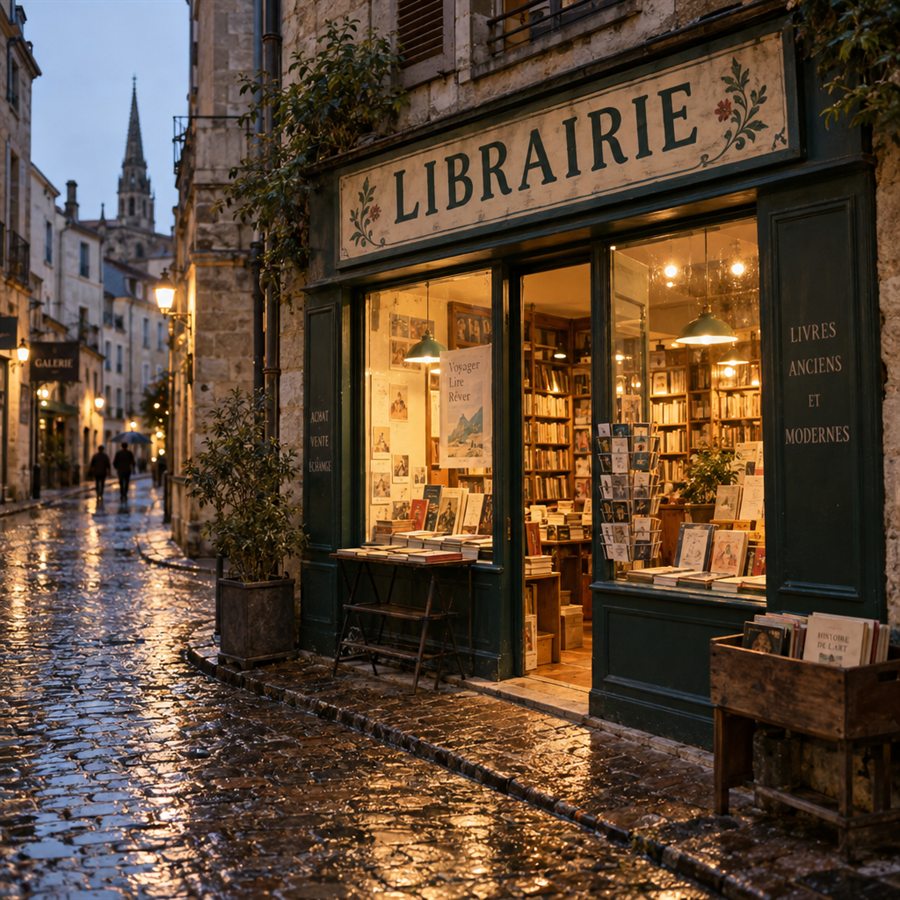
Der Prompt: „Ein kleiner Buchladen in einer europäischen Altstadt am frühen Abend, warmes Licht aus dem Schaufenster, nasses Pflaster nach einem Regenschauer, über dem Eingang ein handgemaltes Schild mit der Aufschrift ‚LIBRAIRIE', fotorealistisch, 35-mm-Look.“
Zum Einsatz kamen die jeweils neuesten freigegebenen Modelle der vier Anbieter: Google Nano Banana 2.1, OpenAI ChatGPT Images 2.5, xAI Grok Imagine Quality und Hugging Face Z-Image-Turbo.
Was die Ergebnisse unterscheiden
Bei identischem Prompt zeigen sich vier Achsen, auf denen sich die Modelle klar unterscheiden:
- Bildaufbau: Straßenszene mit Tiefe (Google), frontale Ansicht (OpenAI), dunkler Ausschnitt (xAI), reine Schaufenster-Nahaufnahme (Z-Image).
- Typografie: OpenAI rendert Schrift am saubersten und ergänzt dekorative Elemente; Google und Z-Image treffen die Aufschrift korrekt; bei xAI wirkt sie flacher.
- Licht und Atmosphäre: Google und xAI setzen stark auf Stimmung und Kontrast, Z-Image bleibt neutraler und sachlicher.
- Tempo: von etwa acht Sekunden (Z-Image-Turbo) bis zu rund 43 Sekunden (ChatGPT Images 2.5) – bei derselben Aufgabe.
Das sind Momentaufnahmen: Bildmodelle werden häufig aktualisiert, und ein anderer Prompt verschiebt die Rangfolge. Für die Praxis heißt das vor allem eines – bei einem wichtigen Motiv lohnt es sich, zwei oder drei Modelle gegeneinander laufen zu lassen, statt auf Anhieb das eine richtige zu suchen.
Die Werkzeuge im Studio
Die eigentliche Stärke liegt weniger im einzelnen Modell als im drumherum. Nach der Generierung lässt sich das Ergebnis direkt weiterbearbeiten: per Freitext beschreiben, was sich ändern soll, oder – bei den ChatGPT-Bildmodellen – Stellen im Bild markieren und gezielt korrigieren. Wer eine Vorlage hat, lädt sie als Referenzbild hoch, statt sie neu zu beschreiben.
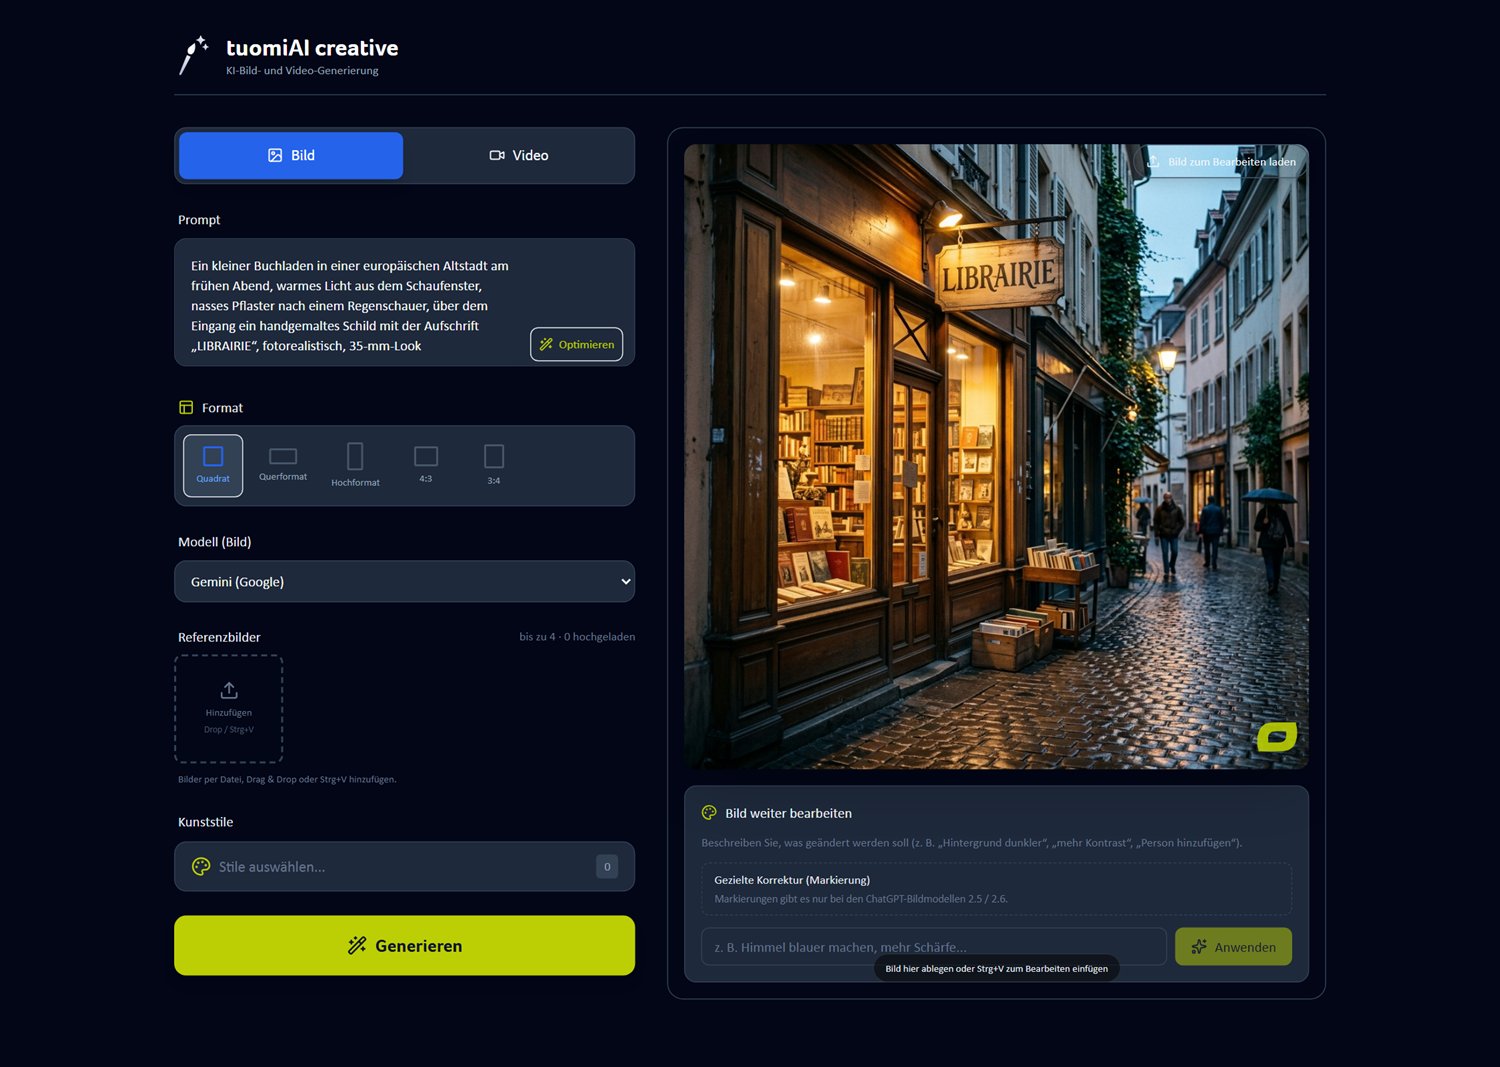
Fünf Formate stehen zur Wahl: Quadrat (1:1), Querformat (16:9), Hochformat (9:16) sowie 4:3 und 3:4. Das spart das nachträgliche Zuschneiden für Website, Präsentation oder Social-Media-Story. Bis zu vier Referenzbilder lassen sich zusätzlich mitgeben – der Hebel für Produktbilder, Markenwelten und wiederkehrende Figuren.
„Bild zum Bearbeiten laden“ öffnet das erzeugte oder hochgeladene Bild erneut im Studio. Statt den kompletten Prompt neu zu schreiben, wird nur die Änderung beschrieben – „Hintergrund dunkler“, „mehr Kontrast“, „Person links entfernen“. Das ist der schnellste Weg zu Varianten, die erkennbar zum Original gehören.
Kunststile: von Höhlenmalerei bis Digital
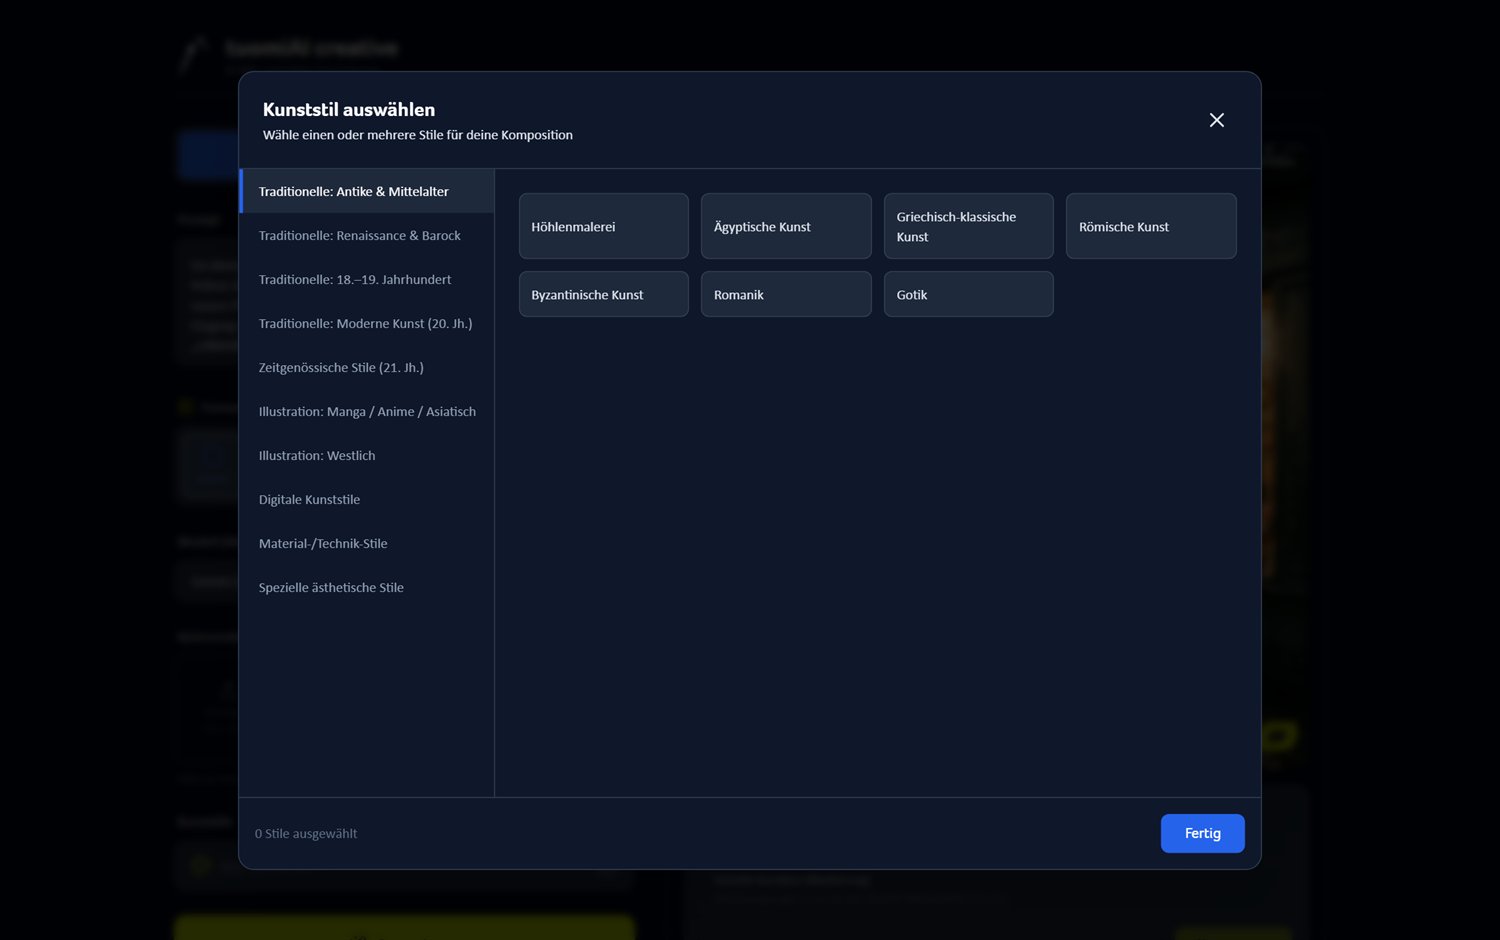
Zehn Kategorien bündeln zusammen mehrere Dutzend Stile – von Antike und Mittelalter über Renaissance, Barock und Moderne bis zu Illustration, digitaler Kunst und Material- beziehungsweise Technik-Stilen. Ein Stil lässt sich mit wenigen Klicks auf die Komposition legen; mehrere Stile sind kombinierbar.
Welche Modelle die Plattform kennt
Der Modellkatalog der Plattform führt zwölf Bildmodelle. Welche davon ein Konto sieht, hängt von der Freigabe ab – im Demo-Account waren acht davon aktiv:
| Modell | Anbieter | Stärke |
|---|---|---|
| Gemini / Imagen | Standard; Referenzbilder und Bildbearbeitung | |
| Imagen 4 | Text-to-Image mit sehr guter Bildqualität ohne Referenzen | |
| Nano Banana 2 | Stark bei Stiltreue und Referenzbildern | |
| Nano Banana 2.1 | Bis zu 14 Referenzbilder, schärferer Text im Bild | |
| Z-Image-Turbo | Hugging Face | Sehr schnell; keine Referenzbilder |
| ChatGPT Images 2.0 | OpenAI | Text-to-Image und mehrere Referenzbilder |
| ChatGPT Images 2.5 | OpenAI | Text-to-Image, mehrere Referenzen, Markierungen |
| ChatGPT Images 2.6 | OpenAI | Neueste Version; beste Editier-Präzision |
| Grok Imagine Quality 2K | xAI | 2K-Ausgabe, bis zu drei Referenzen |
| Grok Imagine Quality (Legacy) | xAI | Bestehende Freigaben, gleiche Engine |
| MiniMax image-01 | MiniMax | Subject Reference, vor allem Charaktere und Porträts |
| Stability AI SDXL | Stability AI | Text-to-Image und Image-to-Image |
Stand: November 2026, entnommen dem Modellkatalog der Plattform. Welche Modelle verfügbar sind, legt der Mandant pro Nutzer oder Tarif fest.
Praktische Tipps für den Start
- Erst das Format wählen, dann das Modell. Ein 16:9-Bild für die Website braucht einen anderen Bildaufbau als eine 9:16-Story.
- Prompt konkret machen: Motiv, Licht, Perspektive, Stil und Kamera in einem Satz – so wie im Beispiel oben.
- Zwei Modelle parallel testen, wenn ein Motiv wichtig ist. Der Unterschied ist größer als der Preisunterschied.
- Referenzbilder für Marken: Produkt oder Logo einmal hochladen statt es in jedem Prompt neu zu beschreiben.
- Kunststile sparsam einsetzen: Ein Stil plus ein klarer Prompt wirkt meist besser als drei Stile gleichzeitig.
Fazit
tuomiAI Creative ist kein einzelnes Bildmodell, sondern eine Werkbank für mehrere. Genau das ist im Alltag der Vorteil: Ein Prompt, vier Ergebnisse, ein Werkzeug – und die Auswahl dessen, was am besten zum Motiv passt. Wer die Modelle einmal gegeneinander gesehen hat, entscheidet deutlich schneller.
Transparenz: Alle Bilder dieses Artikels wurden im Demo-Account der tuomiAI-Plattform erzeugt. Die Vergleichsbilder entstanden mit identischem Prompt, Format 1:1, ohne Kunststile und ohne Referenzbilder.